Opracowanie i komentarz: IRiD Social. Na podstawie publikacji Janne Rottera i Williama Bailkoskiego. Analizowana wersja: arXiv:2510.15509v1, 17 października 2025 r. — preprint.
Dlaczego liczba publikacji nie wystarcza do oceny skuteczności
Organizacja rozważająca wykorzystanie sztucznej inteligencji może znaleźć wiele opisów narzędzi i udanych wdrożeń. Trudniej ustalić, które doświadczenia dotyczą podobnego zespołu, jakie warunki umożliwiły wdrożenie i czy osiągnięty rezultat został niezależnie sprawdzony.
Przegląd literatury pomaga uporządkować taką wiedzę. Jego wartość zależy jednak od sposobu wyszukiwania materiałów, jakości prac źródłowych i ostrożności w łączeniu ich wniosków. Duża liczba pozycji bibliograficznych sama nie przesądza o sile dowodów.
Publikacja Janne Rottera i Williama Bailkoskiego jest punktem wyjścia do takiej rozmowy. Poniżej przedstawiamy jej podstawowe ustalenia, a następnie własną ocenę i propozycję wykorzystania w polskich organizacjach. Praktyczne przykłady oraz program szkolenia pochodzą od IRiD Social.
Autorzy, status i metoda — najważniejsze ustalenia
Janne Rotter i William Bailkoski podają afiliację Universitat Pompeu Fabra w Barcelonie. Wersję v1 pracy „AI Adoption in NGOs: A Systematic Literature Review” zamieszczono w arXiv 17 października 2025 r. Autorzy informują o zgłoszeniu do ACM JCSS; nie jest to potwierdzenie zakończonej recenzji.
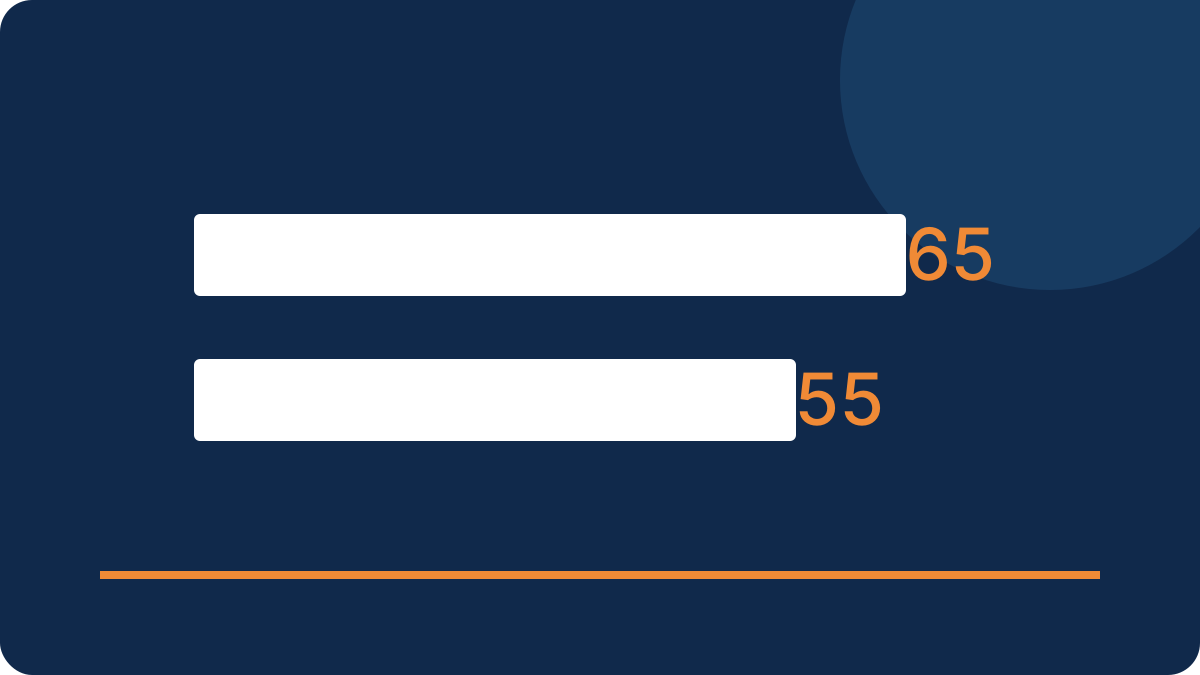
Przegląd obejmuje 65 anglojęzycznych publikacji z lat 2020–2025. Autorzy opisują PRISMA 2020, wyszukiwanie w Google Scholar, OpenAlex, Scopus i ReliefWeb, ocenę jakości oraz syntezę tematyczną i narracyjną zamiast metaanalizy. Posługują się ramą Technology–Organization–Environment (TOE).
Wyróżniają sześć kategorii: Engagement, Creativity, Decision-Making, Prediction, Management i Optimization. Wskazują nierówne możliwości wdrażania i przewagę zasobów większych NGO. W podgrupie 31 prac rozwijających nowe rozwiązania 45,1% nie obejmowało aktywnego zaangażowania NGO.
Źródło ustaleń: pełna wersja v1. Liczba 65 dotyczy publikacji, nie organizacji ani eksperymentów. Deklaracja zgłoszenia do recenzji nie jest potwierdzeniem przyjęcia pracy.
Jak rozumieć wynik przeglądu
Zbiór publikacji nie jest próbą organizacji dobranych do jednego badania ankietowego. Jeden tekst może opisywać pojedyncze wdrożenie, inny grupę podmiotów lub ocenę modelu technicznego. Nie wolno więc utożsamiać liczby prac z liczbą niezależnych, porównywalnych testów skuteczności.
Klasyfikacja zastosowań jest użyteczna jako mapa pytań. Nie stanowi rankingu opłacalności. Obecność danego zastosowania w literaturze nie oznacza, że powinno zostać wdrożone w każdej fundacji lub stowarzyszeniu.
Równie ważne jest rozróżnienie wyniku technicznego i organizacyjnego. Model może poprawnie rozpoznawać wzorzec w danych testowych, a mimo to nie przynieść korzyści w codziennej pracy. Potrzebne jest sprawdzenie całego procesu: wejścia danych, obsługi wyniku i konsekwencji błędu.
Sześć kategorii jako punkt wyjścia do własnej diagnozy
Własne przykłady w poniższej tabeli mają pomóc wybrać zadanie do oceny. Nie są listą rezultatów osiągniętych przez organizacje opisane w przeglądzie. Nazwy kategorii przetłumaczono na potrzeby opracowania.
Na wąskim ekranie przewiń tabelę w poziomie.
| Kategoria — tłumaczenie | Przykład do oceny we własnym pilotażu | Co sprawdzać |
|---|---|---|
| Angażowanie odbiorców | Asystent informacji o publicznej ofercie. | Poprawność, zrozumiałość i droga do doradcy. |
| Tworzenie treści | Projekt zaproszenia na podstawie zatwierdzonych danych. | Fakty, język i czas redakcji. |
| Wspomaganie decyzji | Zestawienie informacji do rozmowy zespołu. | Źródła i możliwość zakwestionowania wyniku. |
| Prognozowanie | Próba przewidywania zapotrzebowania na usługę. | Jakość danych i niepewność prognozy. |
| Zarządzanie | Projekt harmonogramu z określonymi ograniczeniami. | Kompletność i obsługa wyjątków. |
| Optymalizacja | Porównanie wariantów organizacji zadania. | Efekt dla pracowników i odbiorców. |
Nazwy kategorii na podstawie Rottera i Bailkoskiego (2025). Przykłady i kryteria: własna propozycja IRiD Social; nie wyniki badań źródłowych.
Komunikacja z odbiorcami wymaga drogi do człowieka
W naszym przykładowym pilotażu asystent może pomagać znaleźć publiczne informacje o wydarzeniu lub ofercie. Jego zadaniem byłoby uporządkowanie odpowiedzi, z podaniem źródła, które użytkownik może samodzielnie sprawdzić.
Należy ustalić granice takiej funkcji. Pytanie o termin spotkania różni się od prośby o indywidualną ocenę sytuacji uczestnika. Jeżeli zasoby nie pozwalają odpowiedzieć, potrzebna jest jasna informacja i możliwość uzyskania pomocy w inny sposób.
Jakość można oceniać na zestawie pytań o różnym stopniu trudności. Warto uwzględnić błędne założenia, niejasne sformułowania i przypadki spoza zakresu usługi. Test powinien pokazać także, czy osoba o mniejszych kompetencjach cyfrowych rozumie odpowiedź.
Liczba rozmów z asystentem nie jest wystarczającym wynikiem. Ważniejsze, czy użytkownik dotarł do poprawnej informacji i czy otrzymał pomoc, gdy narzędzie nie mogło jej udzielić.
Tworzenie treści wymaga sprawdzania faktów i autorstwa
Przykładem próby może być przygotowanie kilku wariantów zaproszenia na podstawie zatwierdzonych danych. Zespół porównuje zgodność informacji, zrozumiałość i dopasowanie języka. Wszystkie daty, warunki udziału i zobowiązania muszą pozostać zgodne ze źródłem.
Przy materiałach szkoleniowych warto sprawdzać, czy tekst odpowiada celom zajęć, czy przykłady są adekwatne i czy proponowane ćwiczenie można rzeczywiście wykonać. Płynny język nie zastępuje oceny merytorycznej trenera.
Organizacja powinna także znać pochodzenie wykorzystywanych materiałów. Nie należy zakładać, że tekst lub ilustracja są gotowe do publikacji wyłącznie dlatego, że narzędzie je wygenerowało. Zakres użycia i potrzebne oznaczenia trzeba ocenić dla konkretnego materiału.
Proponujemy liczyć czas pełnego procesu, włącznie z kontrolą i poprawkami. Jeżeli przygotowanie pierwszej wersji przyspiesza, ale redakcja staje się dłuższa, rzeczywista korzyść może być niewielka.
Wspomaganie decyzji powinno pozostawiać możliwość weryfikacji
Własny pilotaż można rozpocząć od przygotowania zestawienia informacji do rozmowy zespołu. Narzędzie może grupować publiczne dane, wskazywać brakujące elementy i pomagać porównać warianty. Ostateczna ocena wymaga sprawdzenia źródeł i kontekstu.
Inny poziom odpowiedzialności pojawia się, gdy wynik wpływa na dostęp osoby do wsparcia. Błędna rekomendacja może mieć skutki, których nie widać w statystyce poprawności modelu. Takie zastosowanie wymaga odrębnej oceny przed podjęciem decyzji o pilotażu.
Trzeba ustalić, kto może zakwestionować wynik i jakie informacje otrzyma osoba podejmująca decyzję. Sama obecność pracownika w procesie nie gwarantuje skutecznej kontroli, jeśli nie ma on czasu lub wiedzy do oceny rekomendacji.
W ocenie jakości warto analizować także przypadki pominięte lub nietrafnie zaklasyfikowane. Łączny dobry wynik może ukrywać trudności dotyczące mniej licznej grupy.
Prognozowanie nie jest gotową odpowiedzią o przyszłości
Przykładowym obszarem do rozważenia jest planowanie zapotrzebowania na usługę na podstawie danych historycznych. Przed budową modelu należy jednak sprawdzić kompletność danych i zmiany warunków, w których były zbierane.
Jeżeli dawniej część osób nie mogła skorzystać z oferty, historia zgłoszeń może nie odzwierciedlać całej potrzeby. Model uczący się wyłącznie na takich zapisach może powielać ograniczenia dotychczasowej praktyki.
Prognozę należy przedstawiać wraz z niepewnością i porównywać z prostszą metodą. Czasem czytelne zestawienie trendów daje zespołowi wystarczającą informację przy mniejszym koszcie utrzymania.
Przed wykorzystaniem wyniku warto ustalić, jak organizacja zareaguje na zmianę warunków i po czym rozpozna, że model przestał być przydatny. Są to pytania do własnego wdrożenia, a nie dodatkowe ustalenia przeglądu.
Zarządzanie i optymalizacja wymagają spojrzenia na cały proces
W administracji kandydatem do próby może być porządkowanie publicznych informacji, opracowanie projektu harmonogramu lub wyszukiwanie braków w zestawie materiałów. Zadanie powinno mieć jasne kryteria poprawności i osobę zatwierdzającą wynik.
Przed automatyzacją trzeba opisać wyjątki. Jeżeli proces działa tylko dla najprostszego przypadku, część pracy może zostać przeniesiona na ręczne wyjaśnianie błędów. Wówczas dobry wynik demonstracji nie odpowiada doświadczeniu zespołu.
Przy optymalizacji należy nazwać cel. Skrócenie czasu obsługi, zmniejszenie liczby przejazdów i zwiększenie dostępności to różne zadania. Rozwiązanie korzystne według jednego wskaźnika może pogorszyć inny.
Proponujemy wspólnie ustalić warunki, których nie wolno naruszyć: dostępność dla uczestników, realistyczne obciążenie pracowników i możliwość obsługi nietypowej sprawy. Następnie sprawdzać efekt z osobami, których dotyczy zmiana.
Dlaczego przewaga zasobów nie jest instrukcją kopiowania dużych organizacji
W projektowaniu wsparcia warto oddzielić możliwość zakupu narzędzia od zdolności do jego utrzymania. Mały zespół potrzebuje rozwiązania, które potrafi obsłużyć także po zakończeniu finansowania i przy zmianie personelu.
Własna diagnoza powinna uwzględnić czas pracy, dostęp do wiedzy technicznej oraz możliwość weryfikacji wyników. Cena licencji jest jednym z elementów. Koszt może obejmować również przygotowanie danych, ćwiczenia i obsługę wyjątków.
Nie warto kopiować skali systemu tylko dlatego, że działa w znanej organizacji. Dla mniejszego podmiotu użyteczny może być wąski proces z jasną odpowiedzialnością i krótką instrukcją.
Instytucje wspierające sektor mogą rozważyć wspólne zasoby i konsultacje. Trzeba jednak sprawdzić zasady dostępu, aktualizacji i finansowania, aby małe organizacje nie otrzymały narzędzia wymagającego dodatkowej pracy bez potrzebnego wsparcia.
Jak przełożyć przegląd na program szkolenia
Proponujemy rozpocząć od rozpoznania zadań uczestników. Każda osoba wskazuje jedną powtarzalną czynność i określa, jak wygląda poprawny rezultat. Następnie grupa wybiera przykłady, które można bezpiecznie przetestować na publicznych lub fikcyjnych danych.
Kolejny etap to sprawdzanie wyników. Uczestnicy porównują odpowiedź ze źródłem, identyfikują brakujące informacje i ustalają, kiedy trzeba zrezygnować z użycia narzędzia. To ćwiczenie powinno obejmować także sytuacje, w których wynik brzmi wiarygodnie, ale jest niepoprawny.
Na końcu zespół przygotowuje krótki plan próby: zadanie, osoba odpowiedzialna, sposób kontroli i termin oceny. Po okresie pracy wraca do przykładów i sprawdza, czy zastosowanie rzeczywiście pomaga.
Poniższa propozycja programu jest opracowaniem IRiD Social. Nie należy przedstawiać jej jako szkolenia zweryfikowanego w 65 publikacjach ani jako gotowej ścieżki rekomendowanej przez autorów dla każdej organizacji.
Mocne strony i granice interpretacji
Za wartościową uznajemy próbę uporządkowania rozproszonej literatury i przejrzysty opis etapów pracy. Dla czytelnika planującego wdrożenie szczególnie użyteczne jest rozdzielenie różnych zadań oraz odwołanie do warunków działania organizacji.
Przegląd wymaga jednak ostrożności przy przenoszeniu pojedynczych wyników. Procentowa korzyść opisana w jednej pracy nie staje się przeciętnym efektem dla całego sektora tylko dlatego, że przywołano ją w syntezie.
Różnorodne projekty nie zawsze dają się porównać. Ocena prototypu, ankieta opinii i obserwacja działania usługi odpowiadają na inne pytania. Przed wykorzystaniem konkretnej liczby warto przeczytać badanie pierwotne i sprawdzić jego populację, punkt odniesienia oraz sposób pomiaru.
Także liczba publikacji poświęconych danemu obszarowi nie określa jego znaczenia dla każdej organizacji. Widoczność w literaturze może zależeć od możliwości współpracy z badaczami lub dokumentowania działań.
Status preprintu wymaga jawnego oznaczenia. Nie uzasadnia automatycznego odrzucenia pracy, ale nie pozwala przedstawiać jej jako artykułu po zakończonej recenzji czasopismowej.
Ocena IRiD Social
Publikacja jest użyteczna jako mapa zastosowań i punkt wyjścia do rozmowy o gotowości NGO. Jej praktyczna wartość polega na pomocy w formułowaniu pytań, nie na dostarczeniu uniwersalnej obietnicy oszczędności.
Przedsiębiorstwo społeczne, fundacja lub stowarzyszenie powinny przełożyć wybrany obszar na własny proces i sprawdzić rezultat. Potrzebne są kryteria jakości, odpowiedzialność za wynik i możliwość zgłoszenia trudności przez pracowników oraz odbiorców.
Najbardziej przekonujące uzasadnienie wdrożenia powstanie wtedy, gdy organizacja pokaże, jakie zadanie wykonuje lepiej i jak to zweryfikowała. Przegląd może pomóc zaplanować taką ocenę, lecz jej nie zastępuje.
Proponowany program pracy z zespołem
Na wąskim ekranie przewiń tabelę w poziomie.
| Etap | Zadanie uczestników | Efekt do sprawdzenia |
|---|---|---|
| Rozpoznanie | Opis jednej czynności i jej odbiorcy. | Jasny cel i kryterium poprawności. |
| Dane i materiały | Wybór źródeł do ćwiczeń. | Aktualne materiały bez danych niepotrzebnych do próby. |
| Test | Wykonanie zadania z narzędziem i dotychczasową metodą. | Porównanie jakości oraz pełnego czasu pracy. |
| Kontrola | Weryfikacja trudnych lub błędnych odpowiedzi. | Instrukcja sprawdzania i przekazywania sprawy człowiekowi. |
| Pilotaż | Praca z jednym zadaniem przez ustalony okres. | Rejestr poprawek i doświadczeń użytkowników. |
| Decyzja | Ocena korzyści i kosztów utrzymania. | Rozszerzenie, poprawa albo zakończenie próby. |
Program jest własną propozycją redakcji; nie został zweryfikowany w omawianym przeglądzie.
Źródło, autorstwo i prawa do publikacji
Autorzy: Janne Rotter, William Bailkoski. AI Adoption in NGOs: A Systematic Literature Review. arXiv:2510.15509v1, 2025.
Rekord i historia wersji · Pełny tekst analizowanej wersji · PDF · DOI: 10.48550/arXiv.2510.15509.
Status: omawiamy preprint v1. Nie przypisujemy mu potwierdzonego statusu recenzowanej publikacji czasopismowej. DOI arXiv jest identyfikatorem repozytoryjnym i sam w sobie nie potwierdza recenzji.
Prawa do oryginału: rekord wskazuje niewyłączną licencję dystrybucji arXiv, a nie CC BY. Nie przedstawiamy jej jako otwartego zezwolenia na dowolny przedruk lub tłumaczenie. Nie reprodukujemy wykresów ani pełnego tekstu źródłowego.
Autorstwo komentarza: IRiD Social. Własne omówienie i ocena, z wyodrębnionymi przykładami, tabelami praktycznymi i propozycją szkolenia. Nie jest to pełne tłumaczenie ani publikacja zatwierdzona przez autorów preprintu.
Wcześniejsze opracowania: Badanie 92 przedsiębiorstw społecznych · Przypadek SERI z Irlandii · Technologie i AI w polskich NGO. Źródła mają różne metody i zakresy; ich wyników nie należy łączyć w jeden wskaźnik skuteczności AI.
Ilustracja: Point Normal / Unsplash. Abstrakcyjny motyw nie pochodzi z publikacji naukowej.